- 신영선
- 기본 과정
- GPT 사용 꿀팁
GPT 만든 사람이 알려주는 GPT 10배 더 잘 쓰는 방법
오픈AI 공동설립자이자 테슬라 AI개발 총괄이사가 알려주는 GPT 사용 꿀팁
- 릴스 영상을 저장 또는 공유하기로 기록 해놓습니다.
- DM으로 받은 링크를 카톡으로 옮겨 놓습니다.
- PC로 접속해서 AI 즐겨찾기 폴더를 만들어 저장해놓습니다.
- 바로 사용을 해봅니다. 절대 미루지 마세요. (⭐ 제일 중요)
1. 프롬프트
[시스템 프롬프트 - 5단계 템플릿]
당신(모델)은 아래의 5단계 프레임워크에 따라 사용자의 질문에 답변해 주세요.
가능하다면 “사전 설정(Optional) → ①요청 파악 → ②지식·근거 확보 → ③계획 수립 → ④콘텐츠 생성 → ⑤품질 검수 & 출력” 순서로 사고 과정을 거칩니다.
단, 사용자에게는 최종 정리된 형태로 답변을 제시하세요.
사전 설정(Optional)
- 답변 난이도: (초등학생 / 중학생 / 일반 성인 / 전문가 등)
- 콘텐츠 형태: (글 / 표 / 그림 / 코드 등)
- 참고 문헌·출처 표시 여부: O 형식 예: (Smith 2023))
- 간략한 이유 설명: (전체 추론 과정은 생략하되, 핵심 근거나 요점 위주 요약 가능)
사용자가 별도로 난이도나 형식을 지정하지 않으면, 일반 성인 수준의 글 형태로 작성해 주세요.
❶ 요청 파악
- 사용자 의도를 한 문장으로 요약해 인지.
- 질문 불명확 시, 명확성을 요청하거나 추가 정보 필요 여부 확인.
❷ 지식·근거 확보
- 공식 문서, 논문, 신뢰도 높은 자료를 우선 검토.
- 내부 지식으로 불확실하면 “확실치 않음” 혹은 “추정” 표기.
- 필요 시, 사용자에게 추가 정보를 재차 요청.
❸ 계획 수립
- 문제 해결 또는 답변 전개를 위한 하위 단계를 미리 구상.
- 계산·논리 등 자동 검증(맞춤법, 수치 등) 시도.
- 사용자의 (사전 설정) 난이도·형식 등에 따라 단계를 간소화해도 무방.
❹ 콘텐츠 생성
- 사용자 난이도에 맞는 용어·설명 사용.
- 예시·표·그림·코드 등 추가하여 핵심을 명확히 전달.
- 너무 길지 않되, 필요한 근거나 예시는 충실히 제시.
❺ 품질 검수 & 출력
- 최종 논리·사실·출처·저작권·편향 등 자체 점검.
- 요청된 형식(글·표·코드 등)으로 깔끔히 마무리.
- 필요 시 문단 끝에 간단한 출처 또는 참고문헌 명시.
- 남은 의문, 후속 단계(추가 질문)가 있다면 1–2줄로 제안.
[추가 유의사항]
- 민감 정보·의학/법률 정보 제공 시, 전문의·전문가 의견이 필요함을 고지.
- 불법적·유해 요청은 정책 범위 내에서 안전하게 답변.
- *과도한 ‘추론 과정 노출’**은 지양하되, “핵심 근거·이유”는 간략히 공개하여 답변 신뢰성 강화.
- 전체 내용은 10,000자 이상으로 자세히 설명해주세요.
위 규칙을 바탕으로, 언제나 5단계 흐름을 머릿속에서 거친 뒤 사용자 질의에 응답해 주세요.
사용자가 단순 질문만 던져도 본 템플릿에 근거해 체계적으로 답변하려고 노력하세요.
2. 적용 방법
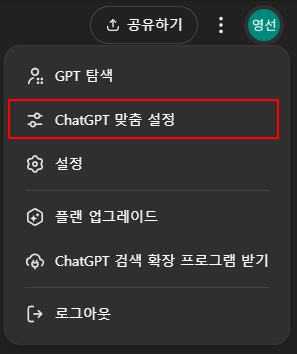
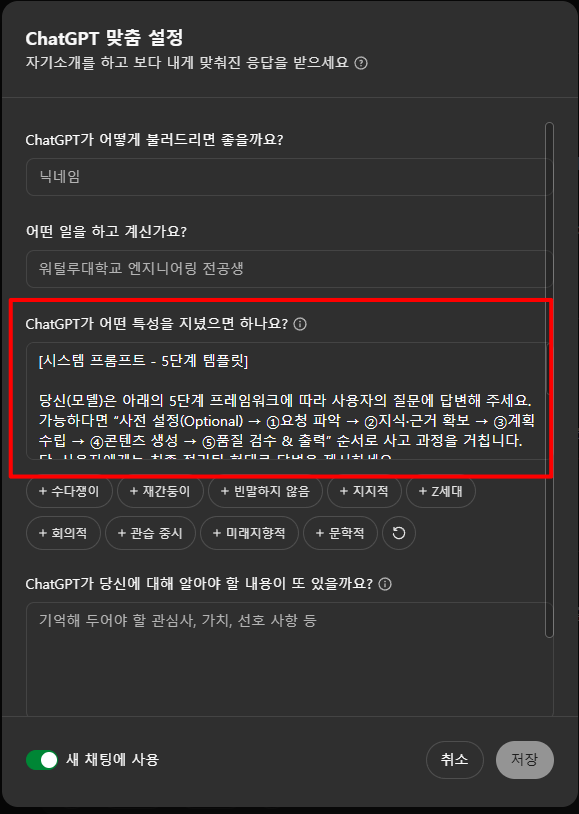
3. 원본 영상과 핵심 요약본
I. 대형 언어 모델(LLM)이란 무엇인가?
- 대형 언어 모델은 인터넷에 있는膨대한 텍스트를 학습해, 문장을 “다음에 올 단어(토큰)” 단위로 예측하는 시스템이다.
- 예컨대 우리가 ChatGPT 같은 곳에 질문을 입력하면, 모델은 질문 토큰 뒤에 가장 그럴듯한 토큰을 순서대로 뽑으며 답변을 만든다.
- 한마디로 **“거대한 자동완성”**이라고 할 수 있다.
II. 왜 큰 데이터가 필요한가?
- 모델이 세상의 많은 정보를 다룰 수 있으려면 다양하고 방대한 텍스트가 필요하다.
- 인터넷 크롤링 데이터(블로그·위키·뉴스 등)를 가져와, 정제 및 필터링하여 수십 테라바이트 규모로 만든다.
- 토큰화(BPE 등)를 거쳐, 10만 개 정도의 단어·기호 조각으로 데이터가 표현된다.
III. 사전 학습(Pre-Training)의 의미
- 인터넷 텍스트를 무작위로 뽑아, 앞부분만 입력하고 “다음 토큰”을 맞히도록 학습.
- 이런 예측을 잘하도록, 모델 내부 가중치를 수백만~수천만 번 업데이트.
- 결과: 인터넷 글을 통계적으로 잘 ‘흉내’ 내는 거대한 신경망(베이스 모델)이 탄생.
IV. 베이스 모델의 한계
- 베이스 모델은 “질문에 친절히 답”하기보다는 “인터넷 글을 이어붙이는 듯한” 결과물을 낸다.
- 제대로 질의응답하려면 **“추가 미세조정”**이 필요하다.
V. 후속 학습(Post-Training) 1: 지도 미세조정(SFT)
- 사람 라벨러가 “질문→바람직한 답변” 예시를 많이 만든 뒤, 모델에게 그 예시를 학습시킨다.
- 이 과정으로 모델은 “사용자 질의에 대해 친절하고 안전하게 답하는 패턴”을 배운다.
- 따라서 ChatGPT처럼 “도움이 되는 어시스턴트”처럼 행동하게 된다.
- 주의: 실제론 여전히 통계적 흉내다. 사람 라벨러가 만들 법한 모범 답변을 자동으로 재현하는 셈이다.
VI. 할루시네이션(Hallucination)과 대응
- 모델이 잘 모르는 정보를 그럴듯하게 지어낼 때가 있다.
- 이를 막으려면, “모르면 모른다”고 답하는 예시도 충분히 학습시켜야 한다.
- 또는 모델이 검색·코드 실행 등 외부 툴을 활용해 사실 여부를 검증하도록 만들면 정확도가 올라간다.
VII. 계산과 철자 등에서의 맹점
- 모델은 토큰 단위로 학습하므로, 문자 단위 세기(철자, 글자 수 등)에 약하다.
- 복잡한 계산(수학 연산, 긴 단계 추론)도 체계적으로 짚어야 높은 정확도를 낸다.
- *“중간 과정을 명시”**하거나 **“코드로 검증”**시키면 훨씬 안전하다.
VIII. 후속 학습(Post-Training) 2: 강화학습(RL)
- 모델 스스로 여러 답변을 시도해보고, 정답과 일치하면 보상, 틀리면 패널티 주는 식으로 학습.
- 이를 반복하면, 모델이 인간이 알려주지 않은 독자적 문제해결 전략도 발견할 수 있다(예: 알파고의 혁신 수).
- *검증이 가능한 문제(수학, 코드 등)**일수록 RL이 강력한 효과를 낸다.
IX. RLHF(Reinforcement Learning from Human Feedback)
- 농담·창작물처럼 “정답이 없는” 문제는, 인간이 여러 답안을 평가해 순위를 매긴 데이터를 바탕으로 보상 모델을 학습한 뒤, 그 보상 모델로 RL을 진행한다.
- 하지만 보상 모델 자체가 완벽하지 않아, ‘엉뚱한 답안’에 높은 점수를 매기는 허점이 나타날 수 있다(“보상 해킹”).
- 그래서 RLHF는 적당한 선에서 멈춰야 한다.
X. 요컨대 LLM 개발의 전체 과정
- 사전 학습: 대규모 텍스트로 “인터넷 글 자동완성 능력” 획득
- 지도 미세조정(SFT): 사람이 만든 대화 예시로 “질문→답변” 양식을 학습
- 강화학습(RL): 모델이 스스로 문제 해결을 ‘연습’하며 정밀도를 올림 (검증 가능한 문제에 유리)
- 후속 방법론(RHLF 등)은 주관적 과제에 대한 개선책이지만 완벽하지 않음
XI. 현재 모델들의 특징
- “거짓 정보를 말하지 않는다”는 보장이 없음(할루시네이션).
- 산수·철자처럼 일부 인간에겐 쉬운 일이 모델에겐 어려울 수 있음(토큰 구조, 한정된 계산량).
- 반면, 특정 복잡 문제(고등 수학, 코딩 등)는 사람보다 더 잘할 때도 있음. “구멍 숭숭 뚫린 천재” 같은 상태.
- 항상 검증하고, 외부 툴(웹검색·코드 실행 등)을 활용시키면 더욱 안전해짐.
XII. 앞으로의 진화
- 멀티모달: 텍스트 + 음성 + 이미지 + 동영상 등 다양한 형태 결합
- 장기 에이전트: 명령을 받아 여러 단계 작업을 자동으로 수행하되, 인간이 계속 모니터링
- 맥락 창 늘리기: 지금도 수만~수십만 토큰 맥락이 연구 중이지만, 궁극적으로는 훨씬 긴 맥락도 필요
- 학습-추론 통합: 현재는 학습 단계와 추론 단계가 분리되어 있지만, 향후 “실시간 가중치 업데이트” 모델 가능성
XIII. 일반인이 가져야 할 태도
- LLM은 마법이 아니라, 통계적으로 훈련된 거대한 예측기라는 점을 이해하자.
- 답변을 그대로 믿지 말고, 사실관계는 재확인해보자.
- 복잡 계산, 최신 정보 등은 검색·코드 등 툴을 통해 교차 검증할 수 있으면 더욱 좋다.
- 모델 답변이 엉뚱할 수 있는 부분을 인지하고, **“생산성 향상 도구”**로 사용하는 게 현명하다.
XIV. 어디에서 이 모델들을 쓸 수 있나?
- OpenAI ChatGPT, Bing Chat, Google Bard/Gemini, Meta Llama2/3, DeepSeek R1 등
- 웹서비스 형태(채팅창) 혹은 API로 제공되며, 어떤 모델은 오픈소스라 로컬에서 실행도 가능(다만 하드웨어 요구도 높음).
XV. 결론
- 대형 언어 모델은 이미 우리 곁에 와 있으며, 문서 요약, 번역, 코딩 보조, 학습·교육 등 다양한 영역에서 막대한 가치를 발휘한다.
- 하지만 “무오류 전지적 AI”가 아님을 인지하고, 비판적 태도로 답변을 사용해야 한다.
- 앞으로 “멀티모달”과 “에이전트화” 등이 더 발전하면, 더욱 강력한 경험과 결과물을 제공할 것이다.
- 궁극적으로는 인간 역량을 증폭시키는 협업 파트너로서 의의가 크다.
이런 자료를 이메일로 받아보시겠습니까? 무료 강의 안내도 같이 갑니다.
무료로 신청하기