- 신영선
- 기본 과정
- Chat GPTo3
샘알트먼이 인정한 역대급 GPT 모델 GPTo3 비교 요약집
Open ai가 직접 최고라고 얘기한 GPTo3 모델
- 릴스 영상을 저장 또는 공유하기로 기록 해놓습니다.
- DM으로 받은 링크를 카톡으로 옮겨 놓습니다.
- PC로 접속해서 AI 즐겨찾기 폴더를 만들어 저장해놓습니다.
- 바로 사용을 해봅니다. 절대 미루지 마세요. (⭐ 제일 중요)
1. 공식 자료
 Introducing OpenAI o3 and o4-miniOur smartest and most capable models to date with full tool access
 openai.com
2. 번역본
1. OpenAI o3 및 o4‑mini 출시 안내 (번역)
오늘 우리는 ChatGPT의 사고 능력을 한층 강화한 o‑시리즈 최신 모델인 OpenAI o3와 o4‑mini를 공개합니다. 이들은 호기심 많은 사용자에서부터 첨단 연구자에 이르기까지 모두를 위한, 지금까지 출시된 모델 중 가장 똑똑한 모델이며, 복잡한 문제를 더 효과적으로 해결할 수 있도록 ChatGPT 내 모든 도구(웹 검색, 파일/Python 분석, 시각 입력 이해, 이미지 생성 등)를 에이전트 방식으로 스스로 판단해 활용할 수 있게 훈련되었습니다.
주요 변경 사항
OpenAI o3
코딩, 수학, 과학, 시각 인지 등 다방면에서 최첨단 성능을 달성
Codeforces, SWE‑bench, MMMU 등 벤치마크에서 새로운 SOTA 경신
외부 전문가 평가에서 o1 대비 주요 실수 20% 감소
생물학·수학·공학 분야에서 가설 생성·비판 평가 능력 탁월
OpenAI o4‑mini
크기 대비 훌륭한 비용·성능 균형 구현
AIME 2024·2025에서 최고 성능
수학, 코딩, 시각 작업에서 o3‑mini 대비 개선
o3 대비 훨씬 높은 사용량 지원
벤치마크 성능 개요
AIME 2024 수학 대회: o3 91.6%, o4‑mini 93.4%
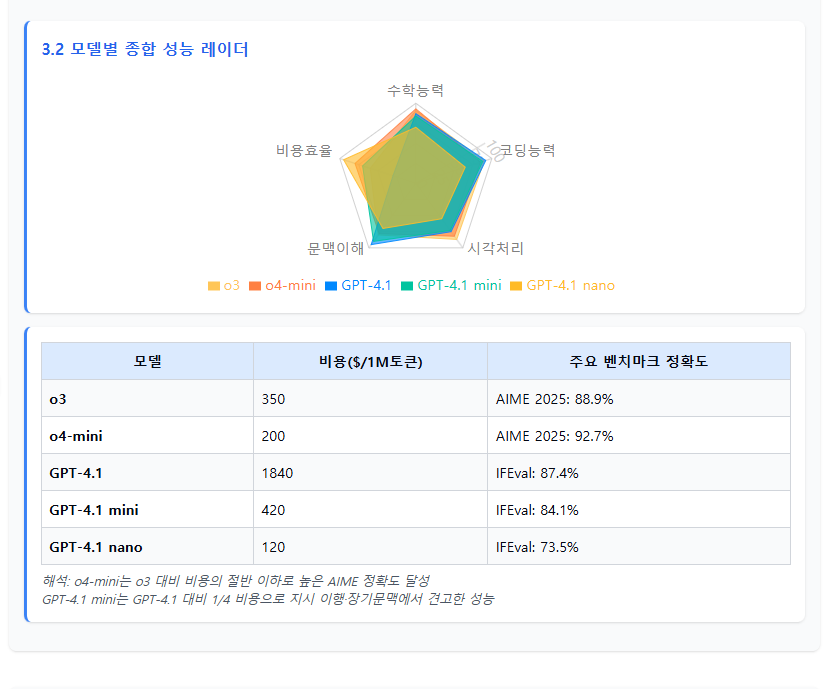
AIME 2025 수학 대회: o3 88.9%, o4‑mini 92.7%
코드포스(High‑effort 모드): o3 ELO 2706, o4‑mini 2719
GPQA 박사급 과학문제: o3 (도구 사용) 24.9%, o4‑mini (도구 사용) 26.6%
MMMU 시각문제: o3 82.9%, o4‑mini 81.6%
MathVista 시각수학: o3 78.6%, o4‑mini 72.0%
SWE‑Bench Verified: o3‑high 81.3%, o4‑mini‑high 68.9%
(모든 모델은 ‘고(高) 사고 노력’ 설정에서 평가)
강화된 에이전트형 도구 활용
웹 검색, Python 코드 실행, 이미지 조작 등의 도구를 ‘언제, 어떻게’ 쓸지 스스로 판단
예: “캘리포니아 여름 에너지 사용량”을 묻자, 웹에서 데이터 수집 → 파이썬으로 예측 모델 작성 → 그래프 생성 → 핵심 인사이트 해설까지 한 번에 수행
시각 입력과의 통합적 사고
이미지를 ‘보는 것’을 넘어, 사고(체인 오브 쏘트) 과정에 직접 통합
화이트보드, 교과서 도표, 손그림 등 흐릿해도 이해·해석 가능
파이썬 도구로 회전·확대 등 전처리까지 에이전트처럼 수행
안전성 강화
바이오위협, 악성코드, 우회(jailbreak) 등 영역별 신규 거절(refusal) 훈련 데이터 구축
인간 가이드라인 기반 모니터링 LLM 도입 → 위험 대화 99% 이상 검출
생물·화학, 사이버보안, AI 자가개선 3대 항목 모두 ‘고위험(High)’ 문턱 이하
Codex CLI 실험
터미널 상에서 스크린샷·스케치와 로컬 코드를 연결해 멀티모달 추론 구현
오픈소스( github.com/openai/codex )로 공개, API 크레딧 지원 프로젝트에 총 100만 달러 규모 보조금 제공
접근권
ChatGPT Plus/Pro/Team: 즉시 o3, o4‑mini 선택 가능 (기존 o1, o3‑mini 대체)
Enterprise/Edu: 1주 내 도입
무료 사용자: ‘Think’ 모드로 o4‑mini 체험 가능
API 개발자: Chat Completions 및 Responses API 통해 o3, o4‑mini 이용 가능
2. o3, o4-mini 모델 비교 그래프 해석 내용
1. 경연대회 수학 & 프로그래밍 대회
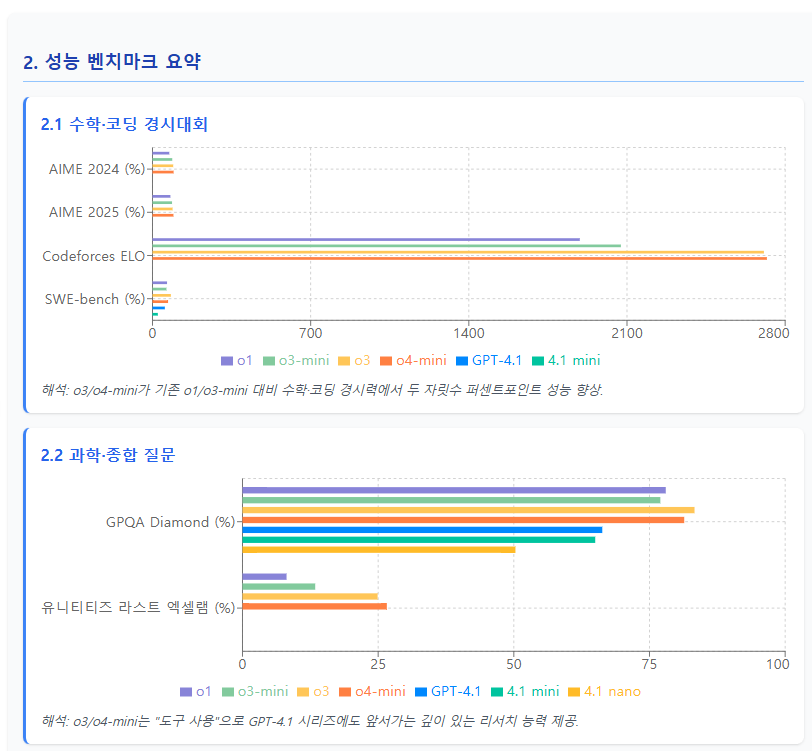
AIME 2024·2025 (Competition Math)
o1 → o3‑mini → o3 → o4‑mini 순으로 정확도가 연속 개선.
AIME 2024: 74.3 % → 87.3 % → 91.6 % → 93.4 %
AIME 2025: 79.2 % → 86.5 % → 88.9 % → 92.7 %
Codeforces (Competition Code)
ELO 점수(높을수록 좋음)도 마찬가지 추세:
o1: 1891 → o3‑mini: 2073 → o3: 2706 → o4‑mini: 2719
→ 신규 모델일수록 수학·코딩 경시력에서 획기적 성능 향상을 보입니다.
2. 고급 과학·종합 질문
GPQA Diamond (PhD‑Level Science Questions)
정확도(%):
o1: 78.0 % → o3‑mini: 77.0 % → o3: 83.3 % → o4‑mini: 81.4 %
Humanity’s Last Exam (Expert‑Level Across Subjects)
“전문가 수준 질문” 정확도:
o1‑pro(no tools): 8.12 %
o3‑mini(no tools): 13.40 %
o3 (with python +browsing): 24.90 %
o4‑mini (with python +browsing): 26.60 %
→ o3·o4‑mini에 도구(웹 검색·파이썬) 사용 기능을 더하면 실질적인 ‘심층 리서치’ 능력이 두 배 이상 뛰어납니다.
3. 멀티모달 시각 문제
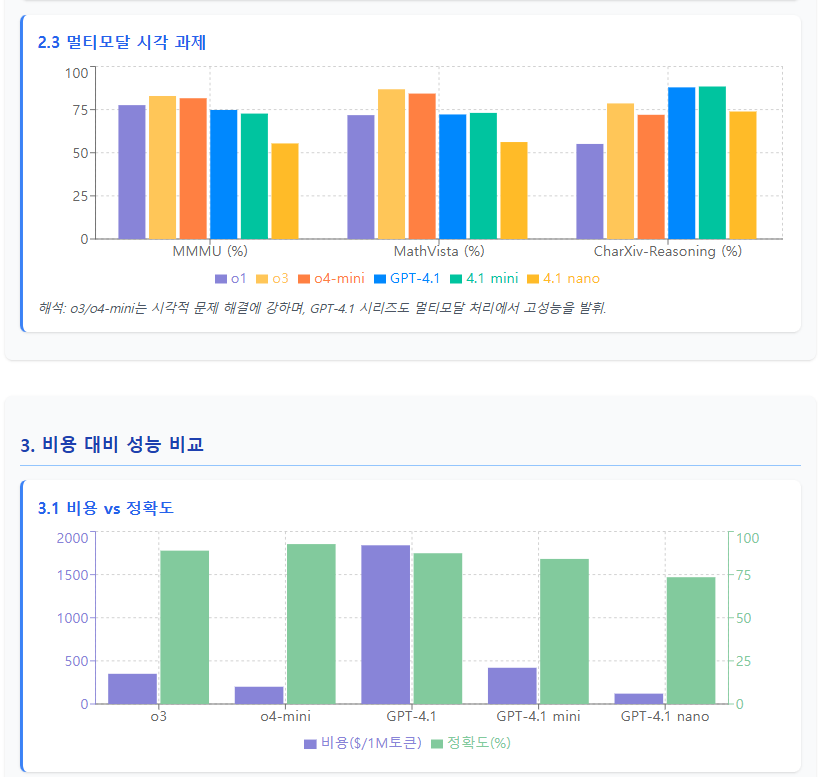
MMMU (College‑level Visual Problem‑Solving)
정확도:
o1: 77.6 % → o3: 82.9 % → o4‑mini: 81.6 %
MathVista (Visual Math Reasoning)
정확도:
o1: 71.8 % → o3: 86.8 % → o4‑mini: 84.3 %
CharXiv‑Reasoning (Scientific Figure Reasoning)
정확도:
o1: 55.1 % → o3: 78.6 % → o4‑mini: 72.0 %
→ 복잡한 그림·차트도 o3/o4‑mini가 훨씬 잘 “읽고” 해석합니다.
4. 코딩 능력
SWE‑Lancer (Freelance Coding Tasks)
추정 연수입(USD):
o1‑high: $28 500 → o3‑mini‑high: $17 375 → o3‑high: $65 250 → o4‑mini‑high: $56 375
SWE‑Bench Verified (Software Engineering)
정확도:
o1: 48.9 % → o3‑mini: 49.3 % → o3: 81.3 % → o4‑mini: 68.9 %
Aider Polyglot (Code Editing)
정확도(Whole vs Diff):
o1‑high: 64.4 %/61.7 % → o3‑mini‑high: 66.7 %/60.4 % → o3‑high: 81.3 %/79.6 % → o4‑mini‑high: 68.9 %/58.2 %
→ 새 모델일수록 복잡한 소프트웨어 공학 과제와 코드 수정 작업에서 대폭 성능이 오릅니다.
5. 명령 이행 & 에이전트형 도구 활용
Scale MultiChallenge (Multi‑turn Instruction Following)
정확도:
o1: 44.9 % → o3‑mini: 39.9 % → o3: 56.5 % → o4‑mini: 42.9 %
BrowseComp (Agentic Browsing)
정확도:
o1‑high: 50 % → o3‑mini‑high: 70.8 % → o3‑high: 52.0 % → o4‑mini‑high: 65.6 %
(Airline vs Retail 실험 모두에서 o3‑mini·o4‑mini가 우세)
→ 다단계 지시 이행과 “스스로 도구(웹/파이썬) 골라쓰기” 능력이 크게 향상되었습니다.
6. 추론 성능 vs. 추론 비용 비교
두 개의 산점도는 **“같은 비용 대비 어느 모델이 더 높은 성능을 내는가?”**를 보여 줍니다.
o1 vs o3
AIME 2025, GPQA Pass@1(도구 없이) 모두에서 동일 비용 대비 o3가 약 5–10 %p 더 높은 정확도를 달성
o3‑mini vs o4‑mini
AIME 2025, GPQA Pass@1(도구 없이)에서 o4‑mini가 o3‑mini보다 비용은 비슷하거나 낮으면서 항상 더 높은 성능
→ 즉, o3는 o1보다, o4‑mini는 o3‑mini보다 “스마트하면서도 저렴”한 추론을 가능케 합니다.
종합 정리
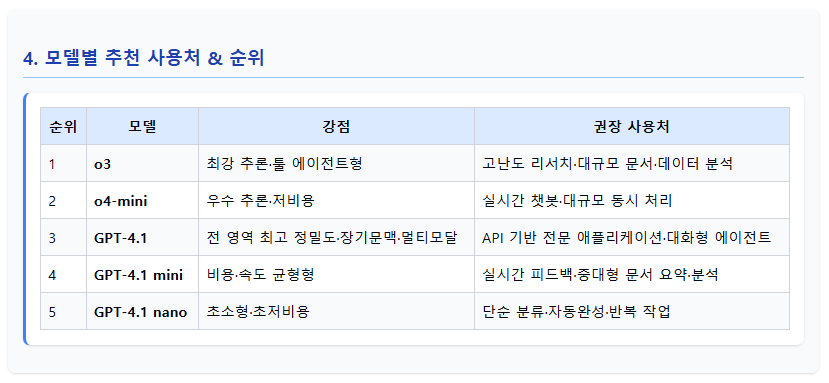
o3: 대규모 모델로, “생각”(deep reasoning)·“스스로 도구 골라쓰기” 능력에서 o1을 압도하며, 학술·수학·코딩·시각·다중 지시 이행 등 전 영역에서 SOTA 성능
o4‑mini: 작고 빠른 모델로, o3‑mini 대비 모든 주요 벤치마크에서 성능 우위, 특히 비용 대비 효율이 뛰어나 높은 빈도의 실시간 활용에 적합
에이전트 기능: 웹 검색, 파이썬, 이미지 조작 도구를 필요할 때 알아서 결합해 사용 → 복잡한 분석-시각화-보고 과정도 단일 요청으로 해결 가능
안전·모니터링 강화: 악성·위험 요청을 99 % 이상 차단, 생물·사이버 리스크 대응력 강화
실제 활용: ChatGPT Plus/Pro/Team 또는 API를 통해 즉시 이용 가능하며, 무료 사용자도 제한적 체험 환경 제공
3. 일반인이 알아야 할 핵심 내용 요약본
- 새로운 똑똑한 AI
‘o3’와 ‘o4‑mini’라는 최신 AI 모델이 출시되었습니다.
기존 모델보다 훨씬 똑똑해져서 복잡한 질문도 척척 해결해 드립니다.
- 필요한 기능을 스스로 골라 사용
인터넷 검색, 그림 분석, 파이썬 코딩 실행 등 다양한 기능을 스스로 판단해 활용합니다.
예를 들어, “오늘 서울 날씨 어때요?”라고 물으면 웹에서 찾아 표로 정리해 주는 식입니다.
- 사진과 그림도 이해
흐릿한 사진이나 손글씨도 읽어서 설명해 드리며, 필요할 경우 이미지를 확대·회전해서 분석합니다.
- 빠르고 효율적
복잡한 수학 문제나 프로그래밍 질문에도 빠르게 답을 찾아 줍니다.
특히 ‘o4‑mini’는 가벼워서 더 많은 질문을 저렴한 비용으로 처리할 수 있습니다.
- 안전하게 설계됨
위험하거나 불법적인 요청(예: 바이러스 제작 방법, 해킹 코드 등)은 자동으로 거절합니다.
사용자와 사회에 해가 될 정보를 차단하는 기능이 강화되어 있습니다.
- 누구나 쉽게 사용 가능
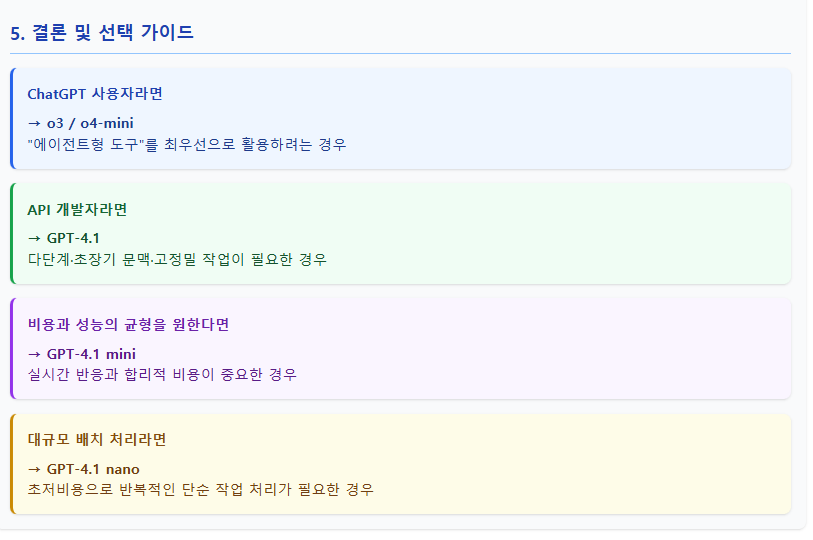
ChatGPT Plus·Pro·Team 요금제를 이용하시는 분은 바로 ‘o3’와 ‘o4‑mini’를 선택할 수 있습니다.
무료 사용자도 ‘Think 모드’를 켜면 ‘o4‑mini’를 체험해 보실 수 있습니다.
- 개발자용 터미널 도구 (Codex CLI)
프로그래밍에 익숙한 분은 터미널에서 스크린샷이나 스케치를 전달해 AI가 코드를 작성하도록 할 수 있습니다.
3. 기존 모델들과의 비교
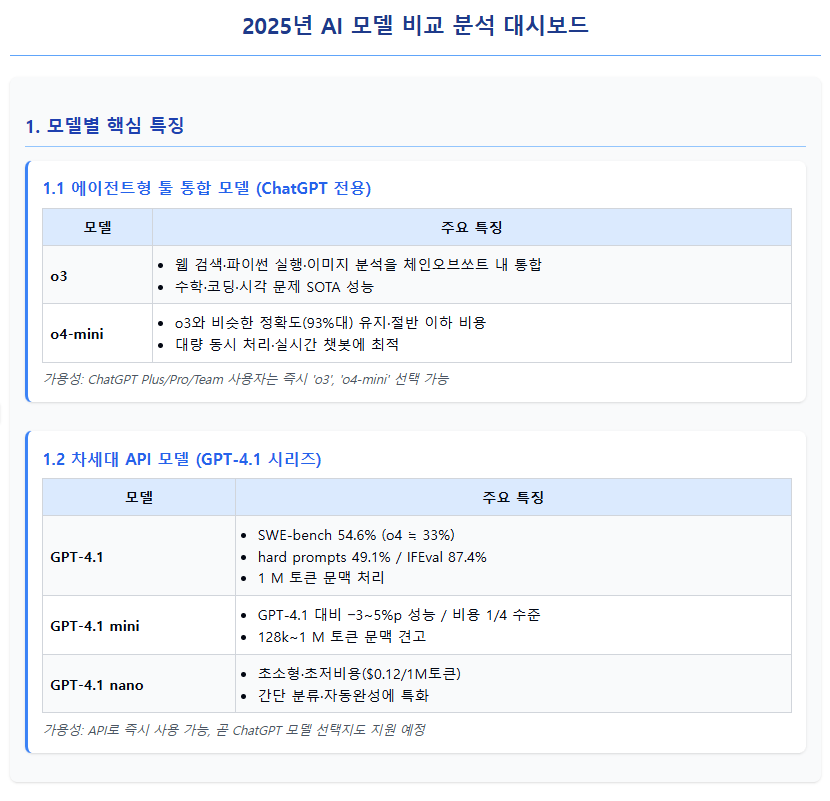
이런 자료를 이메일로 받아보시겠습니까? 무료 강의 안내도 같이 갑니다.
무료로 신청하기